
La tecnica di attacco SQL injection ha più di venticinque anni. La lista OWASP Top 10 la include da quando esiste. Ogni framework moderno offre gli strumenti per evitarla. Eppure continua a comparire nei report di sicurezza delle applicazioni web delle aziende.
La colpa non è degli IT manager. Basta un solo punto del codice scritto nel modo vecchio, spesso anni prima da qualcuno che non lavora più in azienda. Quella vulnerabilità resta lì e nessuno la sta cercando.
Vediamo cosa accade tecnicamente, quali forme assume e perché una scansione automatica ne trova solo una parte.
Che cosa succede in una SQL injection
Ogni applicazione web che mostra dei dati ha bisogno di interrogare un database. Quando cercate un prodotto in un catalogo, l’applicazione prende il testo che avete digitato e costruisce un’istruzione in linguaggio SQL. Poi la trasmette al database, che restituisce i risultati corrispondenti.
Il problema nasce da come l’applicazione costruisce quell’istruzione. Se incolla il testo dell’utente direttamente nella query, il database non ha alcun elemento per distinguere i dati dalle istruzioni. Riceve una stringa unica e la interpreta tutta come linguaggio SQL, perché è esattamente il suo compito.
A quel punto chi scrive nel campo di ricerca non inserisce più un dato in un’istruzione preesistente: scrive una porzione dell’istruzione stessa. È questo il significato del termine injection. Il meccanismo si ripresenta in tutte le altre vulnerabilità di injection. Lo ritroviamo nella XPath injection sui documenti XML e nella prompt injection nei chatbot aziendali. Qui però le contromisure consolidate della SQL injection non valgono più.
Perché il database esegue quelle istruzioni
Il database non commette alcun errore: svolge esattamente il compito per cui esiste. Riceve una query sintatticamente valida e la esegue. Non ha nessuna informazione per sapere che una parte di quella query arriva da un modulo compilato da una persona sconosciuta.
La causa quindi non sta nel database ma nel fatto che dati e istruzioni viaggiano sullo stesso canale, mescolati in un’unica stringa. Finché a separarli c’è soltanto una convenzione di scrittura, quel confine resta soggetto a interpretazione.
Per questo la contromisura corretta deve essere strutturale e non un filtro. Filtrare i caratteri sospetti significa tentare di prevedere in anticipo tutte le forme che un input malevolo potrebbe assumere: le diverse codifiche dei caratteri, le varianti di sintassi SQL tra un motore e l’altro, le funzioni di conversione disponibili. A chi attacca basta un solo caso non previsto. Chi difende deve prevederli tutti.
Per la stessa ragione la OWASP Top 10 dedica alle injection una categoria autonoma: il difetto sta nella progettazione del flusso dei dati e non in una singola riga di codice da correggere.
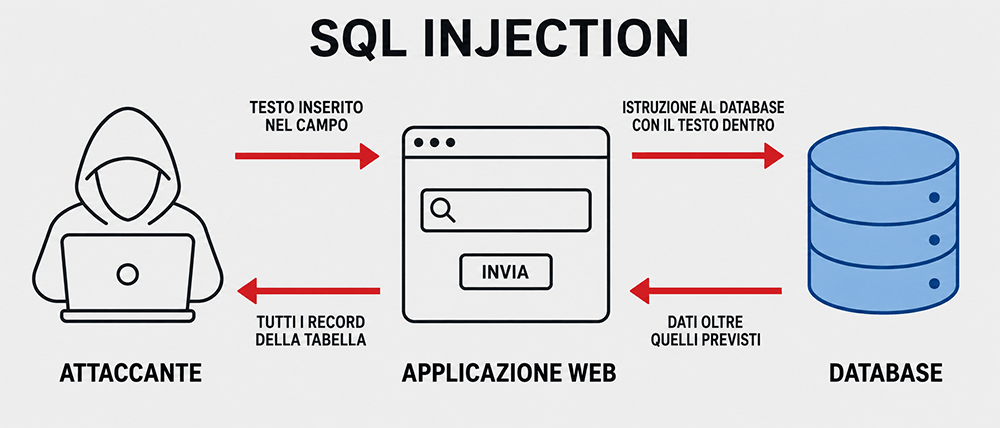
L’applicazione trasmette al database un’istruzione che contiene al suo interno il testo digitato dall’utente. Il database la esegue per intero e restituisce anche i record che l’applicazione non avrebbe dovuto mostrare.
Le varianti principali
Di solito si divide la SQL injection in tre famiglie. Si distinguono per il modo in cui l’attaccante ottiene la risposta dal database e non per la strada da cui l’input ci arriva.
| Famiglia | Come arriva la risposta | Quando si presenta |
|---|---|---|
| In-band | Direttamente nella pagina, nei risultati oppure nei messaggi di errore | L’applicazione mostra all’utente finale gli errori del database |
| Blind | Non arriva in alcuna forma visibile: l’attaccante la deduce dal comportamento della pagina o dai tempi di risposta | L’applicazione gestisce correttamente gli errori ma resta comunque vulnerabile |
| Out-of-band | Su un canale esterno all’applicazione, attraverso le funzioni di rete del database | Il server può collegarsi all’esterno senza controlli |
La forma in-band è la più evidente e anche la più semplice da individuare durante una verifica. Le altre due spiegano perché una pagina che si comporta in modo apparentemente corretto può nascondere una vulnerabilità. La SQL injection di tipo blind non produce nessun output osservabile. Con la variante out-of-band la risposta non passa nemmeno dall’HTTP dell’applicazione.
C’è poi un caso che sfugge quasi sempre alle verifiche superficiali. L’input finisce nel database senza creare alcun problema immediato ed entra in una query solo in un secondo momento, magari attraverso un’altra funzione dell’applicazione o un processo pianificato che gira di notte. Il dato entra in un punto del sistema e il difetto si manifesta in un altro. Chi verifica un campo alla volta non ha modo di collegarli.
Cosa comporta per l’azienda
Il primo effetto riguarda la lettura non autorizzata dei dati. Supponiamo che la query interroghi il catalogo dei prodotti ma che l’account con cui l’applicazione si collega al database abbia accesso a tutte le tabelle. In quel caso l’attaccante raggiunge anche gli archivi di utenti, ordini e credenziali.
Il secondo effetto riguarda la scrittura. Se l’account applicativo ha i permessi necessari, l’attaccante può modificare o eliminare record. In certi casi può anche alterare la logica con cui l’applicazione controlla le autenticazioni, senza conoscere alcuna password.
Il terzo effetto è il movimento laterale nella rete ed è quello che quasi tutti sottovalutano. Un database con privilegi molto ampi può leggere e scrivere file sul sistema operativo che lo ospita oppure raggiungere altre macchine della rete interna. In questo scenario l’applicazione web non è l’obiettivo dell’attacco ma soltanto il punto d’appoggio da cui l’attacco prosegue.
Sul piano normativo, se una vulnerabilità nota espone dati personali il GDPR chiede di gestire e documentare la violazione. Per i soggetti che rientrano nella NIS2 la verifica periodica della sicurezza applicativa fa parte delle misure attese. Ne abbiamo parlato a fondo nell’articolo sulle verifiche documentate e la conformità.
Avete già fatto verificare le vostre applicazioni web su questo?
Il Web Vulnerability Assessment analizza applicazioni e siti seguendo la OWASP Top 10 e restituisce le vulnerabilità che trova in ordine di priorità.
Perché gli scanner automatici non bastano
Uno strumento automatico funziona molto bene sui casi lineari: un parametro da modificare, una risposta che cambia in modo osservabile, un rilievo da riportare. Su un’applicazione reale però trova soltanto una parte del problema.
Questi strumenti si fermano quasi sempre negli stessi punti:
- flussi che richiedono un’autenticazione, dove lo scanner perde la sessione e finisce per verificare pagine di errore anziché funzioni applicative;
- processi su più passaggi, dove il parametro vulnerabile diventa raggiungibile solo dopo aver completato tutti gli step precedenti;
- casi in cui l’applicazione salva il dato e lo usa in un secondo momento;
- parametri costruiti in modo non convenzionale, che lo strumento non riconosce nemmeno come parametri.
C’è poi il problema opposto, che in termini di tempo pesa di più: le segnalazioni che sembrano vulnerabilità senza esserlo. Per distinguerle bisogna provare a sfruttarle in modo controllato. È proprio il lavoro che un Web Application Penetration Test svolge dopo la scansione. Ne abbiamo scritto anche a proposito dei limiti degli assessment automatici.
Questo non significa che gli strumenti automatici siano inutili. Sono il punto di partenza corretto di qualunque verifica. Il problema nasce quando li si considera anche il punto di arrivo.
Come si previene davvero
Le contromisure esistono da tempo. Nella tabella le abbiamo ordinate per efficacia reale sul rischio e non per facilità di adozione.
| Misura | Perché funziona |
|---|---|
| Query parametrizzate | Il valore inserito dall’utente viaggia su un canale separato rispetto all’istruzione. Il database lo tratta come dato e non arriva mai a interpretarlo come codice |
| Privilegi minimi sull’account del database | Limita ciò che un attaccante raggiunge se riesce a sfruttare la vulnerabilità. Un account applicativo non ha alcuna necessità di poter eliminare tabelle |
| Messaggi di errore generici verso l’esterno | Il dettaglio tecnico serve nei log interni, non nella pagina che vede l’utente. Toglie all’attaccante il canale di risposta più immediato |
| Validazione dell’input per tipo e formato | È un livello aggiuntivo di protezione e non la difesa principale. Un campo che deve contenere una data non deve accettare testo libero |
| Web application firewall | Contiene il problema ma non corregge il difetto. Serve a guadagnare tempo quando non potete correggere subito il codice |
| Revisione del codice nei punti che costruiscono query | È lì che si trovano i residui: le funzioni più vecchie, i moduli ereditati da progetti precedenti, le query scritte a mano per aggirare un limite del framework |
ORM e componenti secondari
Un ORM riduce molto il rischio ma non lo elimina. Tutti i framework offrono metodi per scrivere query grezze e gli sviluppatori li usano ogni volta che serve qualcosa che l’ORM non copre. Quei punti richiedono la stessa attenzione del codice scritto a mano, perché è esattamente quello che sono.
Vale infine la pena allargare lo sguardo oltre l’applicazione principale. Le injection compaiono spesso sui componenti secondari: un vecchio pannello di amministrazione ancora raggiungibile, un modulo di ricerca in una sezione poco visitata del sito, un’integrazione con un sistema esterno realizzata anni prima. Sono le parti che nessuno modifica da tempo. E proprio per questo nessuno pensa di verificarle. Un Vulnerability Assessment parte esattamente dal censire ciò che risulta raggiungibile, prima di decidere quali componenti testare in profondità.
Il codice vulnerabile lo scrivono le persone, non gli strumenti.
I percorsi della Cyberment Academy affrontano le vulnerabilità applicative dal punto di vista di chi sviluppa, partendo dagli errori che si incontrano nei progetti reali.
- Autore articolo
- Gli ultimi articoli
Responsabile Marketing per due aziende leader nel settore della Sicurezza Informatica: organizzo e progetto iniziative di diffusione della cultura cybersecurity e dei rischi cyber-crime attraverso contenuti web, eventi on e off line e materiale info-grafico. Ho una naturale propensione per far coesistere il lato metodico e preciso del mio carattere con la parte più creativa, visionaria e ambiziosa di me. Sono curiosa, riflessiva e non metto freni alla mia fame di conoscenza.